En corto
Jev no es un chatbot ni un modelo de código. No escribe respuestas, ni explicaciones, ni programas. Le mandas un estado y una lista de preguntas tipadas, y devuelve una respuesta por pregunta: una probabilidad de sí o no, una opción elegida de una lista que tú definiste, o una posición en una escala que tú describiste. Siempre con probabilidades.
Lo que cambia de verdad es dónde se sienta la IA. En ChatGPT o en un agente de código, el modelo es la interfaz o el trabajador. Jev es una pieza chica dentro de una aplicación normal, en el punto exacto donde el código necesita un juicio, y el resto sigue siendo código de siempre.
Viene de TypeSafe AI, un laboratorio de San Francisco con 40 millones de dólares de ronda semilla, que lo llama un modelo System One. Las cifras de velocidad y precio son suyas y salen de sus propias evaluaciones. La misma empresa admite que están en el extremo alto de lo que verías en la práctica.
Qué es Jev
Un modelo que decide y no escribe. Se entiende mejor comparándolo con lo que ya conoces, y por las dos referencias escondidas en su nombre.
Un if con criterio
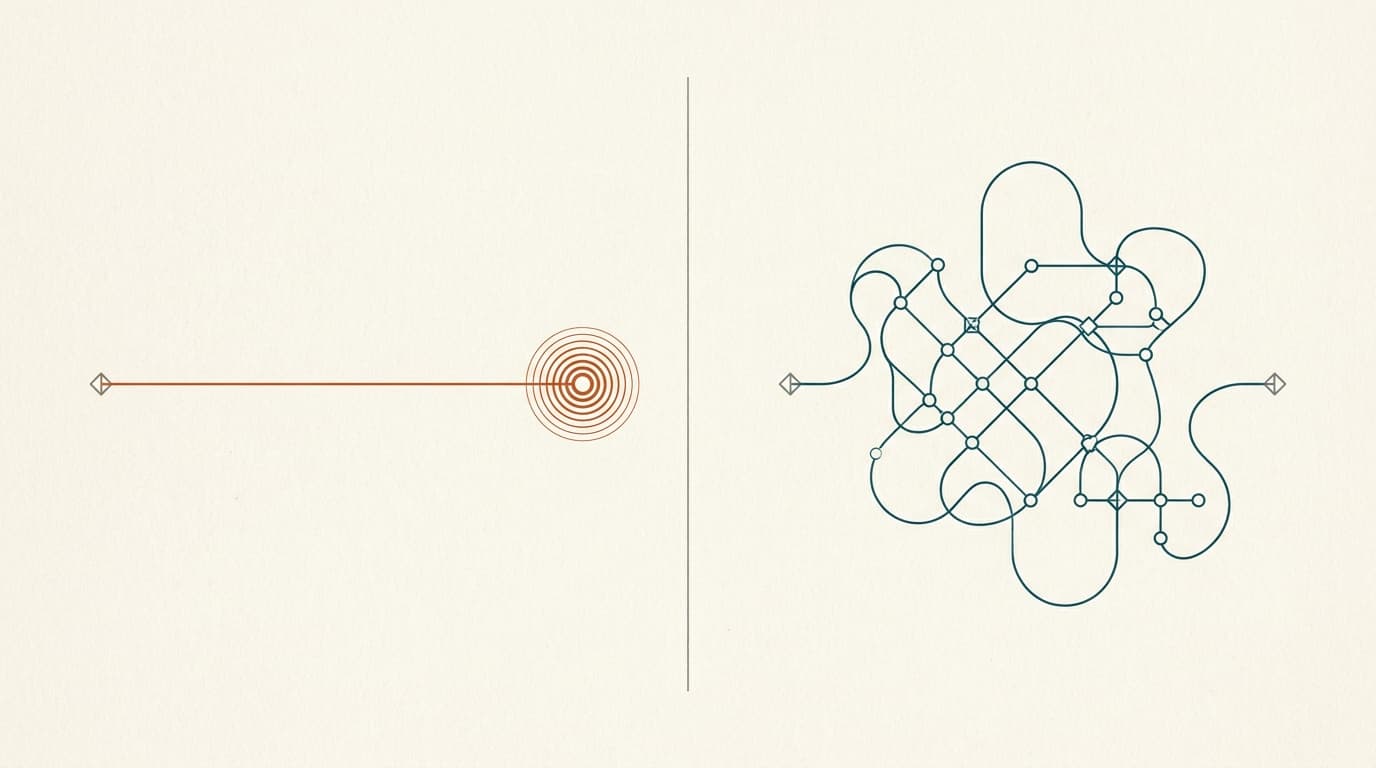
La descripción más corta que funciona: Jev es una sentencia if inteligente.
El código normal se bifurca según valores que puede calcular. if (pedido.total > 100) funciona porque la condición es algo que una computadora comprueba. Se cae en cuanto la condición es un juicio: ¿este mensaje de soporte está enojado? ¿este correo va de facturación? ¿cuál de estos doce botones continúa el pago?
Un modelo de lenguaje responde a eso escribiendo. Genera la respuesta token a token, y luego tu código tiene que rescatar una decisión de dentro de una frase. Jev produce una distribución de probabilidad sobre las opciones que tú definiste, y ahí termina su trabajo.
Un modelo de lenguaje
Escribe una frase
- Genera la respuesta token a token
- Devuelve prosa que hay que interpretar
- En el ejemplo del video tardó 8.5 segundos
- Puede inventarse una categoría que no estaba en la lista
Jev
Señala una opción
- Evalúa las preguntas en paralelo contra el mismo estado
- Devuelve JSON con la opción y su probabilidad
- No puede salirse del esquema que le diste
- No sabe explicarte por qué
Clave
Lo que de verdad cambia
El producto ya no tiene que convertirse en un chatbot, ni el flujo entero en un agente, para tener IA dentro. Te quedas con la aplicación que ya tenías y agregas una llamada en el punto donde un if normal no entiende la entrada.
Lo que no es
Se entiende mejor por descarte, porque el espacio alrededor está lleno de cosas que se le parecen.
| Herramienta | Qué le das | Qué devuelve | Su papel |
|---|---|---|---|
| ChatGPT | Un prompt o una conversación | Una respuesta generada | Asistente general |
| Cursor | Una tarea, un repositorio y herramientas | Ediciones, comandos, tests | Editor y agente de código |
| Codex, Claude Code | Un objetivo y herramientas locales | Llamadas a herramientas y ediciones | Agente de código |
| Jev | Un estado y preguntas con forma de respuesta definida | Elecciones, puntuaciones y probabilidades | Primitiva de decisión dentro del software |
Tampoco es un clasificador clásico, aunque por fuera se le parezca mucho. Un clasificador tradicional necesita ejemplos etiquetados, un entrenamiento y un modelo distinto por tarea. Jev acepta texto sin estructura y preguntas que defines en tiempo de ejecución: hoy clasifica tickets de soporte y mañana revisa un diff, sin reentrenar nada.
“La empresa no ha revelado su arquitectura exacta, pero a todos los efectos se parece mucho a un clasificador. Y un clasificador no es tecnología nueva: lleva más de diez años entre nosotros.”
Mark Kashef · Jev Fully Explained
El matiz que agrega la misma fuente es el que importa: lo nuevo es que el clasificador sea generalista. Le das la pregunta y las respuestas posibles, y clasifica solo con esas dos variables.
Ojo
Y hay algo a lo que renuncia a propósito
No puede escribir una respuesta, ni generar código, ni resumir un documento, ni explicar su razonamiento. Si necesitas texto, sigues necesitando un LLM. La arquitectura interesante son los dos juntos: Jev decide, el LLM escribe cuando hace falta escribir.
System One, por el Sistema 1 de Kahneman
Dos referencias que, una vez que las sabes, explican la apuesta entera de la empresa. La primera es Pensar rápido, pensar despacio, de Daniel Kahneman.
El Sistema 1 es el juicio rápido e intuitivo que tu cerebro hace sin esfuerzo. El Sistema 2 es el razonamiento lento y deliberado. En el marco de TypeSafe, Jev se ocupa del primer tipo de tarea y los modelos de razonamiento del segundo.
Jev, por Jevons y su paradoja
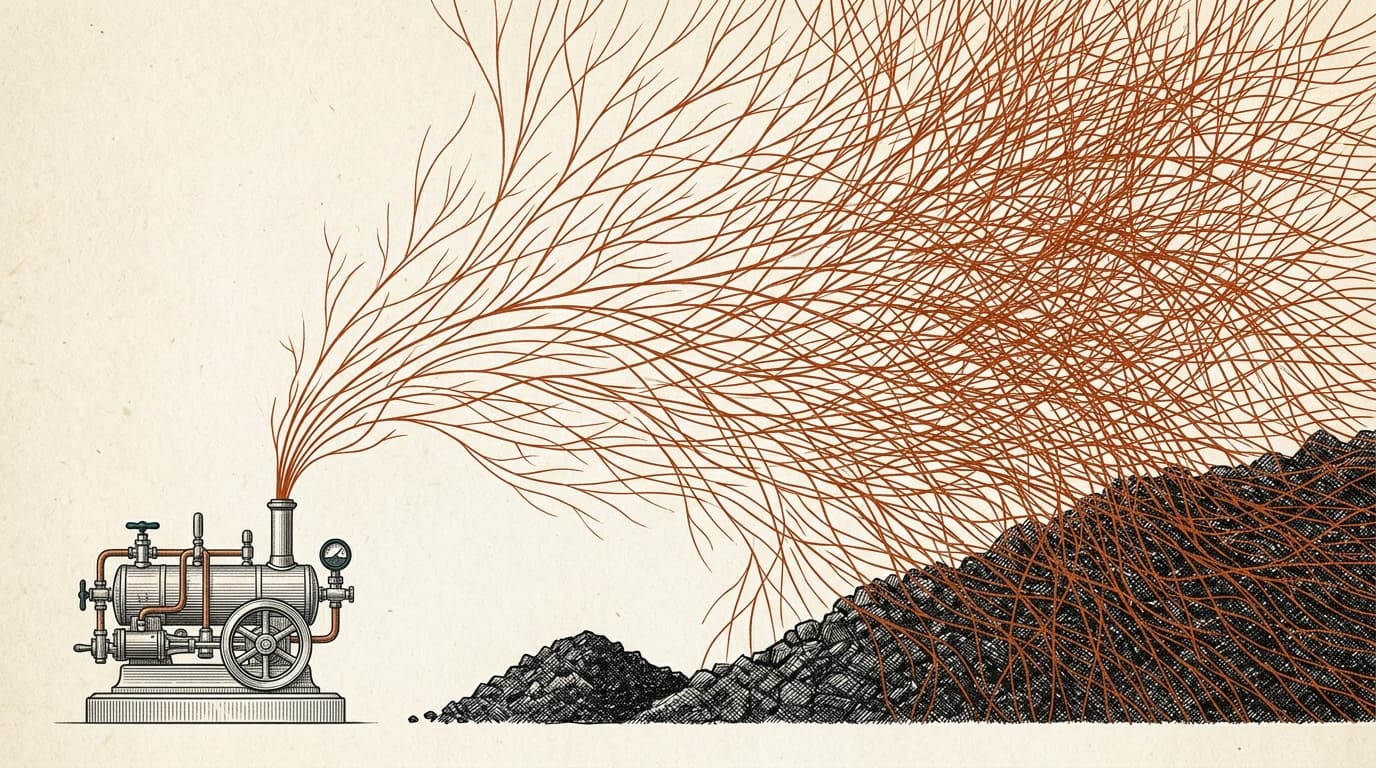
William Stanley Jevons fue el economista de la paradoja que lleva su nombre: cuando las máquinas de vapor se volvieron más eficientes, el consumo de carbón subió, porque la energía barata creó usos nuevos. La apuesta de TypeSafe es que la inteligencia sigue la misma curva. Si una decisión cuesta mucho menos de un centavo, vas a poner decisiones donde nunca habrías llamado a un LLM.
Clave
Por qué esto no es trivia
Si la apuesta sale bien, el sitio donde ocurren casi todas las llamadas a IA deja de verse. Una persona abre ChatGPT unas cuantas veces al día; un software normal puede tomar miles de decisiones diminutas de fondo sin enseñar nunca una interfaz de IA.
Cómo se usa
Un endpoint, dos campos y tres tipos de pregunta. La parte que decide si la integración sirve es la confianza, y lo que significa que esté calibrada.
Cómo se llama
Un endpoint, dos campos. El estado es lo que hay que mirar; las preguntas son lo que quieres saber de él.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json{
"model": "jev-latest",
"state": {
"name": "Managed Postgres",
"description": "We make a managed PostgreSQL hosting product..."
},
"questions": {
"is_sponsor_inquiry": {
"type": "noul",
"instructions": "Does `description` ask to sponsor the site?"
}
}
}model: alias estable. Detrás está hoyjev-1.13.0, y la respuesta siempre dice qué versión contestó.state: lo que hay que mirar. Puede ser una cadena, un objeto o un array.questions: todas se evalúan contra el mismo estado, en paralelo. El ID (is_sponsor_inquiry) es para tu código y no se le manda al modelo.instructions: aquí va la pregunta entera. Las comillas invertidas apuntan a un campo concreto del estado y quitan la ambigüedad.
La respuesta trae answers, el model con la versión que contestó y usage con los tokens. Y luego tu código hace la parte aburrida, que es exactamente donde tiene que estar:
const { answers } = response

if (answers.is_sponsor_inquiry.noul > 0.9 &&
    answers.product_category.choice === 'dev_tool') {
  sendRateCard(email)
} else {
  queueForManualReply(email)
}
Ejemplo del análisis de Flavio Copes.
Clave
Manda solo lo que la pregunta necesita
La precisión baja conforme el estado se llena de contenido que no tiene que ver con la decisión. Filtra en código primero: si puntúas un ticket, no mandes el historial entero del cliente. TypeSafe describe el modelo como afectado por el mismo deterioro de contexto que cualquier otro, y dice que el arreglo está de tu lado.
Dato
El estado tiene un techo de 64,000 tokens
No sale en la documentación que acabo de citar, sino en pantalla en el tutorial de Riley Brown: la ventana de contexto de Jev es de 64,000 tokens de entrada, un 6% de los 1.05 millones de Astra y también un 6% del millón largo de Fable 5.1. Brown lo dice en voz alta como “1.5 millones”, pero el diagrama que él mismo dibuja en pantalla, el que cité, pone 1.05M: me quedo con lo escrito, no con lo dicho. Otra razón, además de la precisión, para no mandarle de más.

Los tres tipos de pregunta
Todo lo que le preguntas es una de tres primitivas. Elegir mal la primitiva es el primer error que se comete.
| Tipo | La pregunta | Qué devuelve |
|---|---|---|
| Noul | ¿Esto es verdad? | noul, una probabilidad de 0 a 1 |
| Choice | ¿Cuál de estas opciones? | choice, probabilities, confidence |
| Score | ¿Dónde en esta escala? | score, legend, probabilities, confidence |
Noul: sí o no. noul es la probabilidad de que la respuesta sea sí. Formula la pregunta de forma que un valor alto signifique sí: un Noul donde true quiere decir “no” confunde al modelo y a quien lea tu código dentro de seis meses.
Ojo
Un 0.5 no significa “a medias”
Preguntas “¿este candidato es fuerte en Python?”, recibes 0.5, y lo que has aprendido es que el modelo no lo sabe. Del candidato no te dice nada. Para medir un grado, usa un Score. Para un sí o no, define la condición de forma que tenga respuesta clara: “¿el currículum dice que usó Python en el trabajo?”.
Choice y Score: una opción, o un punto en una escala
Choice: una de la lista. choice es la opción con más probabilidad, probabilities trae la distribución entera y confidence resume su forma en un número: alta cuando una opción domina, baja cuando la probabilidad está repartida. La documentación insiste en agregar una opción other siempre que tu lista pueda no cubrirlo todo, porque el modelo tiene que elegir algo si no le das salida.
Score: una posición en una escala. El score es la media de los niveles ponderada por probabilidad, así que cae entre niveles: 0 × 0.0 + 1 × 0.7 + 2 × 0.3 = 1.3. Lee siempre probabilities al lado, porque un 1.0 puede ser todo el peso en el nivel 1 o la mitad en el 0 y la mitad en el 2. Son dos situaciones muy distintas con el mismo número, y confidence es lo que las distingue.
La confianza, con y sin un ejemplo relevante
- Niveles como texto plano0.54
score 1.30
- Con un ejemplo relevante0.90
score 1.07
Clave
Cada nivel se juzga por separado
El modelo no ve el número del nivel ni a sus vecinos, así que “peor que el anterior” no significa nada para él. Y mantén cada Score en una sola dimensión: si un nivel dice “puntual y listo y con experiencia”, una entrada alta en una cosa y baja en otra no se puede colocar y la confianza se desploma. Divídelo en tres Scores y combínalos en código.
La confianza es la pieza que vas a usar de verdad
Toda respuesta de Choice y Score trae confidence, entre 0 y 1, calculada a partir de la forma de la distribución. No estás atado a la definición de TypeSafe: la distribución completa viene en la respuesta, así que puedes calcular tu propio estadístico si tu dominio lo pide. La tolerancia al riesgo vive en tu código, en números que puedes leer y cambiar.
1 · Confianza alta
Actúa automáticamente. El modelo tiene una lectura clara.
2 · Confianza media
Actúa con cautela: pide confirmación, marca para revisión o junta más datos.
3 · Confianza baja
No actúes. A una persona, o a un sistema más lento.
Dónde caen las fronteras depende de lo que cueste equivocarse. La documentación usa 0.5 como piso de revisión y 0.9 antes de una acción destructiva, como ejemplos; no hay valores por defecto.
Se ve mejor con un caso de la propia fuente. En una prueba en sombra, un rm -rf ambiguo volvió clasificado como “irreversible” con probabilidad 0.56 y confianza 0.33. Ese 0.33 es lo que le dice al código que le pregunte a un humano en lugar de fiarse de la etiqueta elegida.
Ojo
Empieza conservador y mide
Toma un conjunto de entradas cuya respuesta ya conoces, pásalas, y mira dónde se separan confianza y acierto. Una confianza más alta debería correlacionar con más acierto a lo largo de muchas predicciones, pero no garantiza que una respuesta concreta sea correcta.

Por qué insisten tanto en la palabra calibrado
Es la diferencia entre una probabilidad que significa algo y un número que un modelo escribió porque sonaba bien. Muchos modelos de chat se entrenan con RLHF o con métodos de optimización de preferencias, que premian las respuestas que los humanos prefieren. TypeSafe dice haber entrenado Jev con lo que llama Reinforcement Learning for Calibrated Decisions, que optimiza para que las probabilidades coincidan con los resultados.
Calibrado quiere decir que, a lo largo de muchas predicciones, las respuestas a las que da un 90% de probabilidad aciertan alrededor del 90% de las veces. Sobre una respuesta concreta no dice nada: esa puede seguir siendo un error.
Hay una segunda garantía y conviene no confundirla con la primera. Como el modelo produce una distribución sobre tus opciones en vez de texto libre, una respuesta no puede contener un valor fuera del esquema que le diste. TypeSafe lo publica como un 0% de errores de tipo y aclara que el número sale de la estructura, sin medición detrás. Cubre la forma de la respuesta. Si la opción elegida es la acertada ya es otro asunto.
¿Es la decisión acertada?
Nadie lo garantiza. Se comprueba con ejemplos etiquetados y se vuelve a comprobar cada vez que cambien el modelo, las preguntas, los criterios o los umbrales.
¿Está bien calibrada la probabilidad?
Es lo que TypeSafe dice haber optimizado. Se verifica a lo largo de muchas predicciones, nunca en una.
¿Tiene la respuesta la forma correcta?
Garantizado por construcción. No puede devolver una categoría que no esté en tu lista.
“Una salida tipada no garantiza un enrutado correcto. Un Choice siempre puede devolver uno de los destinos permitidos y aun así mandar la petición al sitio equivocado.”
Flavio Copes · A deep dive into Jev
Dónde se rompe
TypeSafe publica, por cada versión del modelo, una página que llama jaggedness con la lista de lo que hace mal. Esto es lo que hay en ella.
No es una calculadora
No cuenta de forma fiable: ni caracteres de una palabra, ni apariciones de un término, ni elementos de una lista. Dados dos colores en hexadecimal no sabe decir si se parecen. Las preguntas sobre colores con nombre funcionan; las preguntas sobre #FF4B0A, no. La aritmética va en código, y al modelo le pasas el resultado o un intervalo con nombre.
Si necesitas contar elementos que cumplen una condición semántica, haz una pregunta Noul por elemento y suma en código:
const items = ['typesafe', 'apple', 'california', 'banana', 'orange']

const questions = Object.fromEntries(
  items.map((_, i) => [`item_${i}`, noul(`Is \`items[${i}]\` the name of a fruit?`)])
)

const { answers } = await client.systemOne({ state: { items }, questions })

const fruits = items.filter((_, i) => answers[`item_${i}`].noul > 0.5)
console.log(fruits.length) // 3Las fechas son texto para él
Cuál de dos fechas va antes, cuánto distan, si una cae dentro de una ventana: todo eso es poco fiable, y peor con formatos mezclados o referencias relativas.
La solución es partir el trabajo. Extraer es un juicio, así que dáselo al modelo como un Choice sobre meses, días y años con una opción “no consta”, y construye la fecha real en código.
Lee tus palabras, no tu intención
Las negaciones, los condicionales implícitos y las palabras que acotan se leen literalmente. Hay una señal buenísima para detectarlo: cuando miras una respuesta equivocada y te descubres explicando lo que en realidad querías decir, esa explicación es la mitad que le faltaba a la instrucción.
Ojo
Cuidado con el texto que va dentro del estado
El estado es un dato, pero un texto escrito para dirigir al modelo puede mover la respuesta. TypeSafe dice que espera mejorar frente a contenido adversario. Por ahora: criterios precisos, y prueba con entradas hostiles antes de ponerlo de cara al público.
Clave
La regla que resume todas las demás
Con Jev eliges una carta de la baraja, no le pides que nombre una carta. Cada vez que tu instinto diga “extrae X”, reformúlalo como “aquí están los candidatos para X, ¿cuál es?”.
Lo que cuesta y lo que tarda
Las cifras son de TypeSafe, y la propia empresa dice que sus titulares están en el extremo alto. Las de latencia en pantalla cuentan otra historia.
Los números publicados
$0.042
dólares por millón de tokens de entrada. La salida es gratis: casi no hay.
100 ms
latencia típica declarada. El rango publicado va de 70 a 500 ms.
$40M
de ronda semilla, anunciada al salir de stealth el 15 de septiembre de 2026.
Un poco de aritmética. Un ticket de soporte con sus preguntas ronda los 300 tokens en los ejemplos de TypeSafe. Eso son unos 0.0000126 dólares por llamada, o 1.26 dólares por cada 100,000 tickets del mismo tamaño. La calculadora de su web lo pone en otra escala: 0.00042 dólares por cada 10,000 tokens de entrada, así que una petición de ese tamaño sale a 0.00042, mil salen a 0.42 y cien mil a 42 dólares.
Cifras de TypeSafe, medidas desde la costa oeste de Estados Unidos, que es donde corre el servicio.
Ojo
Los titulares de la empresa son un techo
“193.6 veces más rápido, 444.6 veces más barato” sale de sus propias evaluaciones de flujo de trabajo, y TypeSafe dice que esas cifras están en el extremo alto de lo que se vería en la práctica. El multiplicador real depende de contra qué LLM y contra qué tarea.
“20 a 200 veces más rápido, 40 a 400 veces más barato.”
Diogo Almeida · video de lanzamiento, citado en el tutorial de Riley Brown
Ese es el rango que dio el propio fundador el día del lanzamiento, más ancho que el 193.6x / 444.6x de arriba porque cubre casos distintos. Los 40 millones de ronda semilla, este rango y el nombre de Diogo Almeida como uno de los que trabajaron en ChatGPT: todo eso sale de ese mismo video, que Riley Brown reproduce dentro del suyo.
¿Recorta la factura de IA un 50 o un 60 por ciento?
Puede, pero ese número depende del reparto de tu carga de trabajo. Jev solo reduce la parte de la factura que se gasta en decisiones que él puede sustituir.
ahorro total = porcentaje en clasificación × ahorro en esas llamadasSi clasificar es el 60%
Ahorras 5,700 al mes
- 6,000 dólares van a clasificar, enrutar, puntuar y verificar
- La vía nueva cuesta el 5% de eso
- Un 57% de la factura original
Si clasificar es el 10%
Ahorras 950 como mucho
- Solo 1,000 dólares son sustituibles
- Aunque esas llamadas fueran gratis del todo
- El techo del ahorro es el 10%
El ejemplo es de la propia fuente: 10,000 dólares al mes de gasto en IA, con una vía nueva que cuesta el 5% de la vieja.
Clave
Mide el costo por tarea resuelta
El costo por token engaña. Si la vía barata agrega reintentos o revisión humana, el ahorro se encoge al nivel del flujo completo. Un ejemplo de la propia fuente lo deja claro: clasificar 1,018 resúmenes de artículos costó 0.08 dólares con Jev, pero generar esos resúmenes con un LLM costó otros 3.99.
La latencia prometida y la que se ve en pantalla
TypeSafe habla de unos 100 milisegundos. Las cifras de esta sección salen de lo que se ve en los videos de terceros: los dos tutoriales muestran paneles con el tiempo de respuesta impreso, y ninguno de los dos narradores lo lee en voz alta. Son lecturas de sus propias demos, sin nada independiente detrás, pero son lo más parecido a una medición pública que existe ahora mismo.
Milisegundos, según quién lo diga
- Lo que declara TypeSafe100 ms
el rango publicado va de 70 a 500 ms
- Una pregunta suelta, en vivo311 ms
407 tokens de entrada, confianza 0.97
- Una pregunta sin contexto suficiente762 ms
el modelo responde que no hay información bastante, con un 86% de confianza
- Un panel con varias preguntas a la vez2,729 ms
puntuar un título con su desglose completo de curiosidad, especificidad, claridad e intensidad
Ojo
Qué prueba esto y qué no
No refuta la cifra de TypeSafe: sus 100 milisegundos se miden desde donde corre el servicio, y estas lecturas incluyen la red del narrador y, en el último caso, un panel que lanza muchas preguntas. Lo que sí dice es que la cifra que verá tu usuario será otra, y que si vas a meter esto dentro de un bucle de interfaz tienes que medirlo tú desde donde estés.
El análisis independiente de Flavio Copes, hecho desde Italia, dice lo mismo por escrito: espera latencia de red por encima y mediría antes de prometerle nada a una interfaz de usuario.
Qué está construyendo la gente
Jev lleva días fuera. Lo que sigue son experimentos tempranos, y solo uno de ellos se tomó la molestia de compararse contra una línea base.
Etiquetar, enrutar, verificar
El patrón obvio es etiquetar a escala. Una demo temprana clasificó 1,018 resúmenes de artículos de investigación en 24 temas por 0.08 dólares, con una latencia mediana de 256 milisegundos por artículo. Otra prueba pasó 98,000 clasificaciones de anuncios en diez minutos.
- Enrutado de intención y de modelo: una llamada delante de un flujo de soporte o de un agente, decidiendo qué manejador o qué modelo recibe el mensaje.
- Verificación: un sitio que ya genera resúmenes con un LLM comprueba cada afirmación contra la transcripción con un Noul y marca las de probabilidad baja. El LLM escribe, Jev comprueba, el código decide qué necesita revisión.
- Barandillas para agentes de código: clasificar un comando de shell como de solo lectura, reversible o irreversible antes de ejecutarlo.
- Linter semántico: partir el código cambiado en trozos, preguntar cuáles merecen atención y de qué tipo, y mandar solo los prioritarios a un modelo que sepa explicarlos y arreglarlos.
- Ingeniería de características: convertir texto libre en columnas numéricas para un modelo clásico. Un notebook de TypeSafe empieza con 18 preguntas y acaba con 38, que se vuelven 67 columnas para un regresor CatBoost.
La documentación oficial agrupa esto en cinco categorías: automatización, aplicaciones en tiempo real, map-reduce sobre datos masivos, verificación universal e ingeniería del harness. Sirve como mapa, siempre que recuerdes quién lo dibujó: la empresa que vende el producto, describiendo dónde le gustaría que encajara.

Un caso medido: recuperar memoria de una carpeta de notas
En el tutorial de Moritz, la vía anterior adivinaba en qué archivo estaba la respuesta por el nombre del archivo y leía de más. Con Jev delante, el sistema primero decide qué notas vale la pena abrir.
Reducción de tokens frente a la vía anterior
- “¿Cuál es el posicionamiento actual de la oferta?”79%
2,756 tokens frente a 13,408. Costo: 0.00297 dólares frente a 0.01776
- “¿Qué se rompió entre el CRM y el proveedor de correo?”98%
293 tokens frente a 13,035
- Una pregunta cuya respuesta no está en ninguna nota100%
0 tokens: el sistema marca MISSING con p(existe) = 0.09 y no lee nada
Clave
El tercer caso es el interesante
Preguntar por algo que no está en las notas cuesta cero tokens de lectura, porque el juicio semántico responde que ahí no está antes de abrir nada. Es el patrón que se repite en todos los usos serios: Jev decide qué vale la pena mirar, y la respuesta la busca otro.
“Piénsalo como IA de opción múltiple, no como IA de redacción. No conversa. Toma decisiones sobre las que tu software puede actuar.”
Matt Van Horn · WTF Is Jev?
La única medición con línea base
De todo el material publicado, un solo experimento compara Jev contra alternativas tontas. En el tercer proyecto del tutorial, el autor construye un predictor de rendimiento de videos de YouTube sobre 601 videos de 15 canales, con una mediana de 61,877 visitas, y se gasta 0.23 dólares en llamadas a Jev. Lo que vale la pena mirar está en otra pestaña: una que compara su modelo contra líneas base simples, y que dejó a la vista.
| Modelo | RMSE | Spearman |
|---|---|---|
channel_mean_only la media del canal, sin nada más | 1.404 | 0.316 |
ridge_title solo el título, regresión clásica | 1.404 | 0.320 |
code_features_only solo características calculadas en código | 1.365 | 0.339 |
jev_direct_question preguntarle a Jev directamente | 1.332 | 0.370 |
jev_score Jev como puntuador | 1.330 | 0.380 |
jev_plus_code Jev más las características de código | 1.329 | 0.385 |
Predecir con la media del canal y nada más da 0.316. La mejor combinación con Jev da 0.385. Mejora, y lo hace en las tres variantes que lo usan, pero la distancia con no saber nada es corta.
Clave
Y lo que más pesaba no era semántico
El gráfico de importancia de variables de esa misma pantalla pone arriba la duración en minutos (26.6%) y si es un directo (25.1%). La señal semántica que aporta Jev, como que el video ofrezca un curso o formación, queda en el 8.4%. Antes de pedirle juicio a un modelo, comprueba cuánto te da ya lo que puedes calcular con código.
Ojo
Con qué cuidado hay que tomarse esto
Es un experimento de una tarde, de una persona, sobre 601 videos de su nicho, y predecir visitas de YouTube es de las tareas más ruidosas que existen. No generaliza a clasificar tickets ni a enrutar modelos. Lo que vale es el método: poner una línea base tonta al lado. En todo lo demás que se ha publicado sobre Jev no hay ninguna.
El bucle en tiempo real
Unos cientos de milisegundos alcanzan para cerrar un bucle que un LLM no puede cerrar. El ejemplo del tutorial es un navegador que se maneja por voz:
1 · La voz se vuelve texto
mientras el usuario todavía habla.
2 · El servidor mira la página
y hace una lista corta de hasta 100 elementos.
3 · Jev contesta un test
qué quiere hacer, qué elemento, si la frase ya terminó, si esto compra o borra algo.
4 · El código decide y actúa
un puñado de if con umbrales sobre las probabilidades.
El detalle que convierte esto en un patrón está en el último paso. Los if son literalmente así: si “¿es esto una orden?” baja de 0.5, ignórala; si “¿ha terminado la frase?” baja de 0.6, espera más palabras. En el panel de la demo se ven esas mismas señales con sus valores en vivo, is_command 0.85 e is_complete 0.97, junto a la acción que dispararon. Quien hace clic es Playwright, y quien decide es un if que sigue siendo tuyo.
El mismo reparto aparece en la automatización de navegador con un LLM planificador: el LLM decide el objetivo y Jev elige en qué elemento hacer clic, como un Choice sobre los elementos interactivos de la página. Una demo reservó un vuelo en unos siete segundos. David Ondrej enseña lo que parece el mismo clip en su propio tutorial, con un dato que no traía la primera vez: costó 0.004 dólares.
Clave
Por qué un LLM no cierra este bucle
Tarda más, y encima para decidir tiene que razonar a través de los pasos, y ese razonamiento se paga en cada iteración. Un bucle que corre diez veces por segundo no se lo puede permitir ni una vez.

Un router de modelos, hecho en un solo prompt
Riley Brown le pidió a Claude, en un único prompt, un agente que decidiera qué modelo usar según el mensaje de entrada. El agente reparte entre cuatro niveles y Jev es quien elige cuál.
1 · Nano
“Hey, soy Riley.” Un saludo. Jev lo manda al modelo más chico.
2 · Fast
Tareas simples que no piden razonar.
3 · Balanced
“Quiero construir un wrapper de API.” Jev eligió Claude Sonnet 5 con 95% de confianza.
4 · Frontier
Reservado para lo más pesado. En la demo, nunca se disparó.
El mismo video reúne otras tres demos de terceros. Justin Schroeder recreó algo parecido al piloto automático de Tesla: le da a Jev un árbol de opciones (seguir recto, girar, frenar) y el modelo decide en cada instante según lo que hay en pantalla, incluidos semáforos y peatones. Un usuario identificado como Jared conectó Jev a una cuenta de trading real en jevtrader.vercel.app: el modelo decide comprar, vender o mantener, con su nivel de confianza al lado. Y en el tutorial de David Ondrej, alguien de Cognition AI llamado Nader construyó una hoja de cálculo que puntúa cada fila según una columna que se escribe en texto libre, como “urgencia”, y lo hace en unos 100 milisegundos por cientos de filas mientras se escribe.
Ojo
Son demos elegidas por otro, no una muestra
Ninguna de las tres tiene una fuente más allá del clip que un creador decidió incluir en su video. No hay forma de saber cuántos intentos fallidos hay detrás, ni si el árbol de decisión del coche cubre casos que el clip no mostró.
Comparar contra Astra, tarea por tarea
Jack Roberts corrió la misma tarea contra Jev y contra Astra, una y otra vez, con el cronómetro y el costo en pantalla. Es la comparación más sistemática de las tres, aunque el mismo video vende su curso.
Mismo lote de 20 correos, cronómetro en pantalla
- Filtro de spam y estafas, con Jev3.41 s
0.00038 dólares las 20 pruebas: unos 0.02 dólares por cada 1,000, extrapolando
- El mismo filtro, con Astra9.93 s
4.68 dólares por cada 1,000 correos, cifra exacta en pantalla: casi 3 veces más lento y unas 245 veces más caro
Las dos pruebas que más distancia muestran no son de correos. Detectar si un texto está escrito por IA le costó 4 centavos con Jev contra 15 dólares con Astra, sobre el mismo lote. Y para buscar la referencia más parecida dentro de una librería de más de 300 sistemas de diseño, Jev salió en 1.94 dólares por cada 1,000 consultas contra 507.52 dólares con Astra (Roberts lo redondea a “500” al hablar), unas 260 veces más caro, y ambos encontraron la misma referencia.
David Ondrej trae dos gráficas más, y ahí conviene mirar el fotograma en vez de quedarse con el resumen que dice en voz alta. La tasa de error en salida estructurada no es un bloque parejo de “0.8-1%”: Luna y Terra están en 0.58%, Sol en 0.83%, Astra en 1.43%, y el dato que se pierde si solo escuchas es que Haiku 4.5 llega a 45.5%, muy por encima de cualquier otro modelo del gráfico. En la tasa de error al usar herramientas, Jev vuelve a estar en 0% y Astra en 16.6%, pero el peor no es Astra: Sol llega a 17.0%. Los modelos de Anthropic (Opus 5, Fable 5.1, Haiku 4.5, Sonnet 5) se mueven entre 0.67% y 2.07%, un rango más ancho que el “alrededor de 1.3%” que resume el narrador.
Ojo
Quien mide también vende
Los tres números de arriba salen de creadores que promocionan un curso, una comunidad o un hosting en el mismo video. Nadie publicó el detalle del cronómetro ni corrió el experimento por fuera. Y son costos por tarea suelta, no por flujo completo: la reserva de la nota sobre el costo por tarea resuelta aplica igual aquí.
Por dónde empezar
El modelo responde la pregunta que escribiste, que no siempre es la que querías decir. Casi todo el oficio está ahí, y en meterlo una rama a la vez.
Casi todo el oficio está en escribir las preguntas
- Un juicio por pregunta. “¿Este mensaje transmite urgencia?” es una buena pregunta. “Analiza este mensaje y decide el mejor curso de acción” no lo es, porque esconde varios juicios detrás de una respuesta.
- Escribe la condición exacta. Si la respuesta depende de un matiz, el matiz va en la instrucción. En tu cabeza no le sirve a nadie.
- En los criterios, describe situaciones concretas. “Función rota, existe un rodeo” le da al modelo algo con lo que comparar el estado. “Moderadamente grave” no.
- Dale una salida. Una opción
otheren todo Choice cuya lista pueda no cubrirlo todo, y un “no consta” cuando extraes algo que puede faltar. - Que instrucción y criterios digan lo mismo. Cuando la instrucción pide una cosa y los criterios describen otra, la respuesta se degrada.
Clave
Dos hábitos sobre el código de alrededor
Pon todas las preguntas y todos los umbrales en un solo archivo, porque son la parte de la integración que una persona necesita revisar. Y versiona juntos el modelo, las preguntas, los criterios y los umbrales: si cambias uno sin los otros, la comparación con tu histórico deja de significar nada.

Una rama cada vez
- Regístrate en la lista de espera de typesafe.ai, o usa el AI Gateway de Vercel con el ID de modelo
typesafe-ai/jev, al mismo precio, si tienes cuenta y no quieres esperar. - Pasa la primera hora en el Playground con tus datos, no con los ejemplos. Pega un mensaje de soporte real, una línea de log real, un formulario real.
- Elige una decisión aburrida que tu código ya resuelve a mano, o con una expresión regular que se rompe a cada rato: enrutar, aprobar, saltar.
- Sustitúyela por un Noul o un Choice, y registra la confianza durante una semana en paralelo al comportamiento actual, sin dejar que actúe.
- Solo entonces déjalo actuar, y solo por encima del umbral que hayas medido.
Dato
Hay plan gratuito
La consola de TypeSafe incluye 30 millones de tokens al mes gratis. A 300 tokens por llamada son del orden de 100,000 decisiones mensuales sin pagar, de sobra para la semana de registro en paralelo del paso 4.
Ojo
Instala su skill antes de pedirle a un agente que lo integre
TypeSafe publicó una skill para agentes precisamente porque los agentes entrenados con APIs de LLM cometen los mismos dos errores: hacen una pregunta por llamada y se inventan campos de la petición.
# la vía corta, visible en la consola
npx @typesafe-ai/cli setup

# o la skill para el agente, por marketplace
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai

# Cursor, Codex y el resto
npx skills add typesafe-ai/skills --skill typesafe-ai
Clave
Y lo primero que conviene descartar
Para decisiones que el código determinista ya resuelve bien, el código sigue siendo lo primero. Un if que no cuesta nada le gana a una llamada a un modelo que puede equivocarse.
Glosario
Las palabras que vas a encontrar en la documentación
System One
La categoría que TypeSafe inventó para Jev, por el Sistema 1 de Kahneman: juicio rápido e intuitivo, frente al razonamiento deliberado del Sistema 2.
state
El contenido sobre el que van las preguntas. Una cadena, un objeto JSON o un array. Manda solo lo que la decisión necesita.
Noul
Pregunta de sí o no. Devuelve una sola probabilidad, sin campo de confianza aparte.
Choice
Pregunta de opción múltiple sobre una lista que tú defines. Hasta 255 opciones.
Score
Posición en una escala que tú describes, de 2 a 10 niveles, ordenados de menor a mayor.
confidence
Un número de 0 a 1 calculado a partir de la forma de la distribución. Alto cuando una opción domina; bajo cuando la probabilidad está repartida.
Calibrado
Que a lo largo de muchas predicciones, las que reciben un 90% de probabilidad acierten en torno al 90% de las veces. De una respuesta concreta no dice nada.
Jaggedness
La página que TypeSafe publica por cada versión del modelo con la lista de lo que hace mal.
Cierre
Qué queda sin responder
Nada de lo que hay aquí es una medición independiente del rendimiento. Las cifras de velocidad, precio y calibración son de TypeSafe. Lo más cerca que hay de una comprobación externa son los contadores que se ven en las demos de terceros y el único experimento que se molestó en poner una línea base al lado, y los dos están arriba con sus reservas.
Falta alguien que ponga Jev en producción con tráfico real, durante semanas y no en una demo de una tarde, y que publique el costo por tarea resuelta incluyendo los reintentos y la revisión humana, que es justo la cifra que decide si el ahorro existe o se queda en la presentación.
Yo voy a probar Jev en cuanto tenga acceso. Le veo potencial para repartir tareas entre distintos LLMs, que decida qué va a un modelo de frontera y qué a uno chino, y para manejar la computadora desde el navegador con extensiones de Chrome. Ya veremos si llega a ser lo que promete o se queda en otra herramienta de moda.
Fuentes
De dónde sale esto
Ocho fuentes: un análisis independiente largo, la documentación de la propia empresa, un artículo y cinco tutoriales en video, la mayoría de creadores que también venden un curso o un hosting al lado. Cuando una afirmación viene solo de TypeSafe, o solo de quien la está vendiendo, el texto lo dice.
Web
A deep dive into Jev, TypeSafe's System One model
Flavio Copes · 17-09-2026
La fuente más completa y la única independiente que entra en los límites del modelo. Casi 11,000 palabras.
flaviocopes.com/jevDocumentación
Example use cases, documentación de TypeSafe AI
TypeSafe AI · septiembre de 2026
Documentación oficial. Es la voz de la empresa sobre su propio producto.
docs.typesafe.ai/concepts/use-case-mapArtículo en X
WTF Is Jev? 9 Things People Are Already Building With It
Matt Van Horn (@mvanhorn) · 18-09-2026
Un recorrido por lo que la gente está construyendo con Jev en sus primeros días.
x.com/mvanhornVideo
Jev: The New AI Model That's Breaking The Internet (Full Tutorial)
Moritz, AI Systems · 17-09-2026
Tutorial de 22 minutos con tres proyectos construidos en directo.
youtube.com/watch?v=Nq_lu5QT-fIVideo
Jev Fully Explained: 10 Practical Ways to Use It
Mark Kashef · 18-09-2026
La lectura más escéptica, de alguien que construyó clasificadores durante años.
youtube.com/watch?v=zZNm4zP_lEEVideo
JEV: How It Works and What You Can Build
Riley Brown · 18-09-2026
Un router de modelos hecho en un solo prompt, el tamaño real de la ventana de contexto y una tanda de demos de terceros.
youtube.com/watch?v=o1CogAtWdBkVideo
Build Anything with Jev, Here's How
David Ondrej · 19-09-2026
Trae la tasa de error de salida estructurada y de uso de herramientas, comparadas contra Astra. El resto del video es, en buena parte, publicidad de un hosting.
youtube.com/watch?v=f6We53TnkbUVideo
Jev AI Just Dropped, And…
Jack Roberts · 19-09-2026
Cinco tareas corridas en paralelo contra Astra con el cronómetro en pantalla: la comparación más sistemática de las tres, aunque vende su propio curso a la vez.
youtube.com/watch?v=9C8opPBjAIk